Edge AI vs Cloud AI: De Juiste Architectuur Kiezen voor Enterprise-Systemen
Nu bedrijven zich haasten om generatieve AI en machine learning te adopteren, staan systeemarchitecten voor een fundamentele keuze: Waar moet de model-inference draaien?
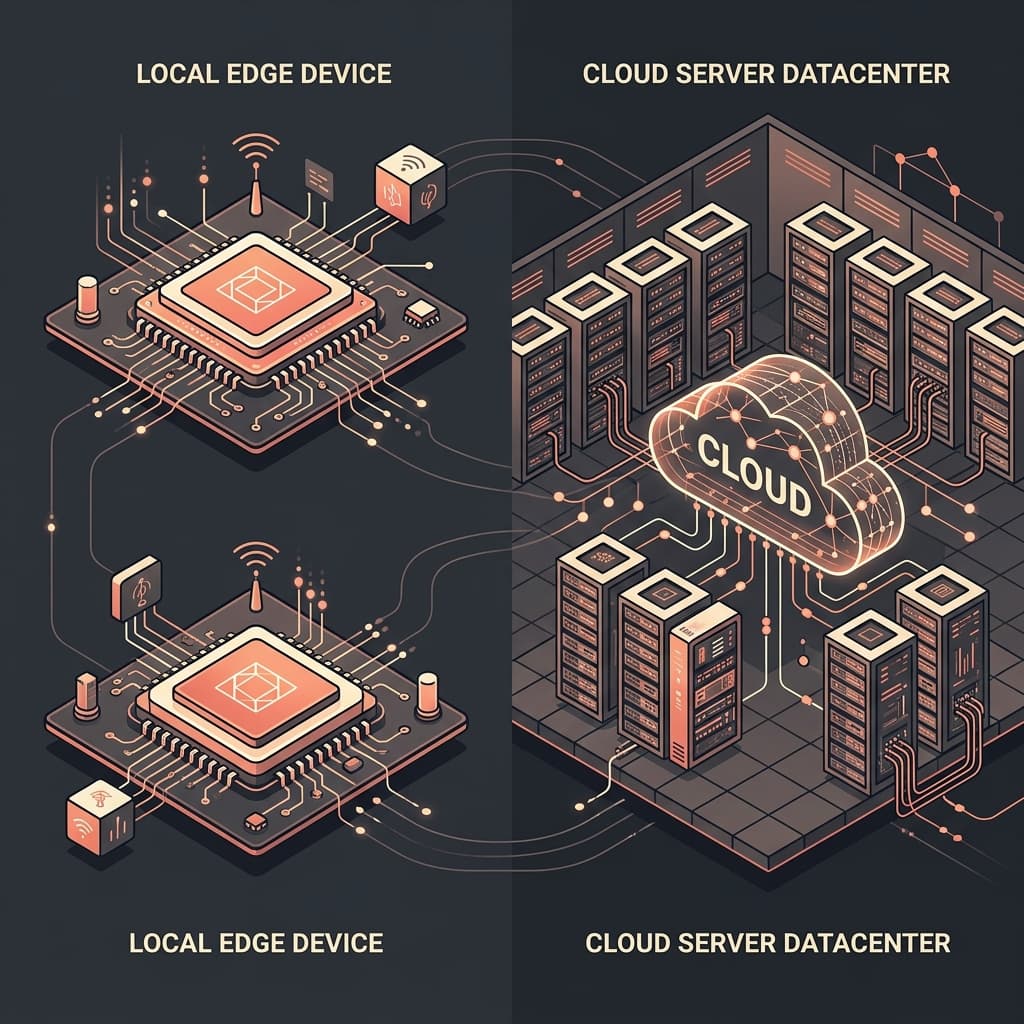
Aan de ene kant is er Cloud AI-dat vertrouwt op hyperscalers en API-providers (zoals OpenAI, Anthropic of AWS Bedrock) om enorme, geavanceerde modellen te draaien op krachtige GPU-clusters. Aan de andere kant is er Edge AI-het lokaal implementeren van gekwantiseerde modellen op hardware van eindgebruikers, mobiele apparaten of gespecialiseerde on-premise hardware met behulp van engines zoals Llama.cpp, ONNX Runtime of Apple's CoreML.
Elke benadering brengt aanzienlijke technische afwegingen met zich mee op het gebied van latentie, operationele kosten, netwerkafhankelijkheid, geheugengebruik en beveiliging.
Deze gids biedt een uitgebreid technisch kader om organisaties te helpen deze afwegingen te evalueren en hybride architecturen te ontwerpen die het beste van twee werelden combineren.
1. De Paradigma's Definiëren
CLOUD AI-ARCHITECTUUR (Gecentraliseerde Inference)
+-------------+        Internet / WAN     +----------------------+
| Edge Client |=========================>| Cloud GPU Datacenter |
| (Thin App)  |<=========================| (FP16 / FP8 Inference)
+-------------+   Hoge Latentie / Band   +----------------------+

EDGE AI-ARCHITECTUUR (Gedistribueerde Inference)
+----------------------------------------+
| Edge Device (Werkstation / Mobiel)     |
| +-------------+        +-------------+ |  Geen Externe Netwerk
| | Client App  |<======>| Local Engine| |  Vereist
| | (React/Web) |  IPC   | (INT4 LLM)  | |
| +-------------+        +-------------+ |
+----------------------------------------+
Cloud AI
In een Cloud AI-architectuur is de inference gecentraliseerd. De client verzamelt de inputs (bijv. chatlogs, afbeeldingen, sensortelemetrie) en verzendt deze via een WAN (HTTPS of WebSockets) naar een cloud-endpoint. De server regelt de tokenisatie, batching, GPU-wachtrijplanning, model forward passes en stream-generatie, en stuurt de resultaten terug naar de client.
- Voorbeeldmodellen: GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro.
- Parameters: 100 miljard+ tot 1 biljoen+ parameters (vaak MoE - Mixture of Experts).
Edge AI
In een Edge AI-architectuur is de inference gedistribueerd. De client draait een native engine die de modelgewichten laadt in het lokale geheugen (RAM/VRAM) van het apparaat en matrixberekeningen uitvoert op de lokale CPU, GPU of NPU (Neural Processing Unit).
- Voorbeeldmodellen: Llama-3-8B-Instruct, Phi-3-Mini, Gemma-2B.
- Parameters: 1 tot 15 miljard parameters, doorgaans gekwantiseerd naar INT4 of INT8.
2. Technische Vergelijkingsmatrix
Laten we de belangrijkste statistieken voor systeemontwerp analyseren:
| Architectonische Metriek | Cloud AI | Edge AI |
|---|---|---|
| Inference-precisie | Native FP16 / FP8 | Gekwantiseerd INT4 / INT8 |
| Initiële Latentie (TTFT) | 300ms - 1000ms (Netwerkafhankelijk) | 50ms - 150ms (Hardwareafhankelijk) |
| Gegevensprivacy | Gedeeld met derden (opt-out mogelijk) | Absoluut (Geen gegevens verlaten de hardware) |
| Netwerkvereisten | Continue breedbandverbinding | Volledig offline werking |
| Hardwarekosten | Betalen per token API of GPU-instanties | Kapitaaluitgaven (CapEx) voor edge-hardware |
| Schaalbaarheid (Concurrency) | Beheerd door cloudproviders | Lineair geschaald door edge-hardware toe te voegen |
3. Diepduik: Inference-latentie en Doorvoer
Knelpunten van Cloud Latentie
Voor cloudgebaseerde systemen is de latentie als volgt opgebouwd: $$\text{Latency}{\text{Cloud}} = t{\text{network_roundtrip}} + t_{\text{queue_delay}} + \text{TTFT}{\text{model}} + (N{\text{tokens}} \times t_{\text{generation}})$$
Waarbij $t_{\text{network_roundtrip}}$ wordt bepaald door geografische routering en TLS-handshakes, en $t_{\text{queue_delay}}$ fluctueert op basis van de serverbelasting van meerdere gebruikers (multi-tenant). In bedrijfsnetwerken met complexe proxy-lagen en SSL-interceptie kan de netwerklatentie alleen al 150ms tot 400ms per verzoek toevoegen.
Edge-latentie en Geheugenbeperkingen
Voor edge-systemen is de netwerklatentie nul. De uitvoeringssnelheid van het model is echter volledig afhankelijk van de geheugenbandbreedte van het lokale apparaat. Tijdens autoregressieve token-generatie is LLM-inference sterk geheugen-gebonden: $$\text{Tokens per Seconde} \approx \frac{\text{Memory Bandwidth (GB/s)}}{\text{Model Weight Size (GB)}}$$
Een Llama-3-8B-model gekwantiseerd naar INT4 neemt bijvoorbeeld ongeveer 4,5 GB geheugen in beslag. Op een moderne Apple Silicon-laptop met 150 GB/s geheugenbandbreedte is de doorvoer: $$\text{Throughput} \approx \frac{150 \text{ GB/s}}{4,5 \text{ GB}} \approx 33,3 \text{ tokens/sec}$$
Als hetzelfde model wordt geladen op een budget kantoor-pc met standaard dual-channel DDR4 RAM met een bandbreedte van 40 GB/s, daalt de doorvoer naar minder dan 9 tokens/seconde, wat de applicatie traag maakt.
4. Kwantisering: Grote Modellen Draaien op Kleine Hardware
Om modellen op edge-apparaten te laten passen, moeten we kwantisering (quantization) toepassen-het converteren van floating-point gewichten (FP16) naar gehele getallen met een lagere precisie (INT8, INT4 of zelfs 2-bits gewichten).
Kwantisering Transformatie:
[FP16 Matrix Element: 0.89437213]  ===> Kwantiseren (Schaal & Offset) ===> [INT4 Element: 6]
Deze optimalisatie vermindert het geheugengebruik en maakt vectorisatie mogelijk op moderne edge-processors (zoals ARM NEON of x86 AVX-512):
- FP16-grootte: 8B parameters = 16 GB geheugen vereist.
- INT8-grootte: 8B parameters = 8 GB geheugen vereist.
- INT4-grootte: 8B parameters = 4,5 GB geheugen vereist.
De prijs van kwantisering is een minimaal verlies in perplexity (het redeneervermogen van het model). In onze benchmarks behoudt een naar 4-bit gekwantiseerd Llama-3-8B-model ongeveer 97% van zijn oorspronkelijke FP16-intelligentie voor standaard classificatie- en samenvattingstaken, terwijl het slechts een fractie van de rekenkracht en het geheugen vereist.
5. Beveiliging & Datasoevereiniteit: De Compliance-dimensie
In gereguleerde sectoren (gezondheidszorg, juridische sector en overheid) is gegevensbescherming van cruciaal belang.
- Het Cloud-risico: Het uploaden van Personally Identifiable Information (PII) of beschermde gezondheidsinformatie (PHI) naar cloud-API's kan in strijd zijn met regelgeving zoals de AVG (GDPR) of HIPAA. Zelfs met zakelijke verwerkingsovereenkomsten lopen securityteams risico's door datalekken of gecompromitteerde API-sleutels.
- De Edge-oplossing: Met Edge AI blijven de gegevens op het apparaat. Een lokale medische assistent-applicatie kan patiëntendossiers lokaal verwerken, samenvattingen maken en deze rechtstreeks opslaan in een lokale, versleutelde database, waarbij WAN-verbindingen volledig worden omzeild.
6. Hybride Architecturen: Het Beste van Twee Werelden
Om de redeneerkracht van de cloud te balanceren met de snelheid, lage kosten en beveiliging van de edge, pleit Seven Labs voor Hybride AI-orkestratie.
                        HYBRIDE AI-ORKESTRATIE PIJPLIJN

                        +-------------------------------+
                        |   Binnenkomende User Query    |
                        +-------------------------------+
                                        |
                                        v
                        +-------------------------------+
                        |   Router / Intent Classifier  |
                        |      (Lokaal 2B Parameter)    |
                        +-------------------------------+
                                        |
                    +-------------------+-------------------+
                    | (Eenvoudige Taken)                    | (Complexe Redeneringen)
                    v                                       v
       +-------------------------+             +-------------------------+
       |   Edge Execution Engine |             |  Cloud Execution Engine |
       | (INT4 Local Model / NPU)|             | (GPT-4o / Cloud GPU API)|
       +-------------------------+             +-------------------------+
                    |                                       |
                    +-------------------+-------------------+
                                        v
                        +-------------------------------+
                        |     Geformatteerde Respons    |
                        +-------------------------------+
Routeringslogica
- Lokale Intent-classificatie: Een klein lokaal model (zoals Phi-3-Mini) analyseert de invoer van de gebruiker.
- Padselectie:
- Als de taak eenvoudig is (bijv. gegevensinvoer, formaatconversie, basisplanning), voert het lokale model de inference lokaal uit tegen verwaarloosbare kosten.
- Als de taak complex redeneerwerk vereist of het vergelijken van meerdere ingewikkelde datasets, wordt de query via een beveiligde, versleutelde relay (zoals het Seven Labs Bluetooth AI Relay-systeem) naar GPT-4o geleid.
- Fallback-coördinatie: Als de client de internetverbinding verliest, valt het systeem automatisch terug op lokale verwerking.
7. Praktijkvoorbeeld: Seven Labs Bluetooth AI Relay
In ons praktijkproject hebben we deze architecturen overbrugd. Een werkstation zonder internetverbinding draaide lokale edge-applicaties, maar wanneer complexe, externe redeneringen nodig waren, maakte het gebruik van onze Bluetooth-relay om veilig cloud-intelligentie te benutten:
- Lokaal: Het Android-apparaat beheerde de versleutelde, lokale transport-socket.
- Extern: Gegevensversleuteling op edge-niveau vond plaats voordat de gegevens via het mobiele netwerk naar GPT-4o werden verzonden, wat edge-beveiliging en cloud-intelligentie combineerde.
8. Veelgestelde Vragen voor Bedrijven
Wat zijn NPU's en waarom zijn ze belangrijk voor Edge AI?
Neural Processing Units (NPU's) zijn speciaal ontworpen processors die zijn geoptimaliseerd voor de massale matrixberekeningen die worden gebruikt in neurale netwerken. Door taken van de CPU en de hoofd-GPU over te nemen, kunnen NPU's model-inference verwerken met een 5x tot 10x hogere energie-efficiëntie, wat de batterij van mobiele apparaten spaart.
Kan Edge AI offline vector-databases draaien?
Ja. Databases zoals HNSWLib of Chroma-lite kunnen rechtstreeks in client-applicaties worden geïntegreerd. Het lokale apparaat kan embeddings lokaal genereren met behulp van een klein sentence-transformer-model en de lokale vector-database volledig offline bevragen.
Wat is het verschil in ontwikkelkosten?
Edge AI vereist het optimaliseren van code voor meerdere apparaatconfiguraties, het beheren van de beperkingen van OS-achtergrondprocessen en het compileren van native binaries (C++/Rust). Cloud AI kent een lagere initiële ontwikkelingswrijving, maar brengt doorlopende operationele API-kosten met zich mee die meegroeien met het verkeer.
Technische SEO-schema & Interne Links
- Trefwoorden: Edge AI vs Cloud AI, Hybrid AI Architecture, local LLM inference, model quantization.
- Interne Links:
- Ontdek onze Diensten voor AI-platform engineering voor aangepaste implementaties.
- Lees hoe we veilige lokale datasystemen hebben geoptimaliseerd in onze Casestudies.
- Neem contact op om te zien hoe we je systeemeisen kunnen evalueren via onze Contactpagina.
Implementeer de Juiste AI-architectuur met Seven Labs
Bepalen of je modellen lokaal of in de cloud moeten draaien is niet alleen een softwarebeslissing-het is een strategische zakelijke keuze die van invloed is op compliance, kosten en gebruikerservaring. Het engineeringteam van Seven Labs is gespecialiseerd in het bouwen van krachtige, kosteneffectieve en veilige hybride systemen die zijn afgestemd op jouw specifieke infrastructuur.
Neem contact op met de architecten van Seven Labs om vandaag nog je enterprise AI-infrastructuur te ontwerpen.